Tienes el Titanic en un DataFrame. Quieres saber la edad media por clase. Escribes df.groupby('Pclass')['Age'].mean() y Pandas te devuelve tres filas: 38.2, 29.9, 25.1. Limpio. Razonable. Pero a los dos minutos necesitas algo distinto: una columna nueva en el DataFrame original que diga cuánto se aleja cada pasajero de la media de su clase. Y .mean() ya no te sirve. Necesitas .transform(). Y aquí es donde .agg() y .transform() se confunden hasta en la documentación oficial.
groupby es posiblemente la operación más potente de Pandas. Y también la peor explicada. En la UT03 del libro la trabajo siempre con el mismo movimiento en tres pasos, el mismo ejemplo, y una tabla al final que lo deja claro. Te lo cuento.
El patrón que nunca cambia: Split, Apply, Combine
Da igual lo que quieras calcular —un conteo, una media, una suma, un máximo—: el movimiento es siempre el mismo. Pandas primero divide el DataFrame en subgrupos, uno por cada valor único de la columna por la que agrupas. Con Pclass en Titanic son tres grupos invisibles: primera, segunda y tercera. Después aplica una función a cada subgrupo de forma independiente. Por último combina los resultados en una Serie o un DataFrame nuevo.
Lo que diferencia a .agg() de .transform() no está en el Split ni en el Combine, sino en la forma del resultado final.
import pandas as pd

url = 'https://raw.githubusercontent.com/jgarcia314/analisis-datos-python-fp/main/data/raw/titanic.csv'
df = pd.read_csv(url)

df.groupby('Pclass')['Age'].mean()                       # media de edad por clase
df.groupby('Pclass').size()                               # pasajeros por clase
df.groupby(['Pclass', 'Sex'])['Survived'].mean()         # supervivencia por clase y sexo
.agg(): un valor por grupo
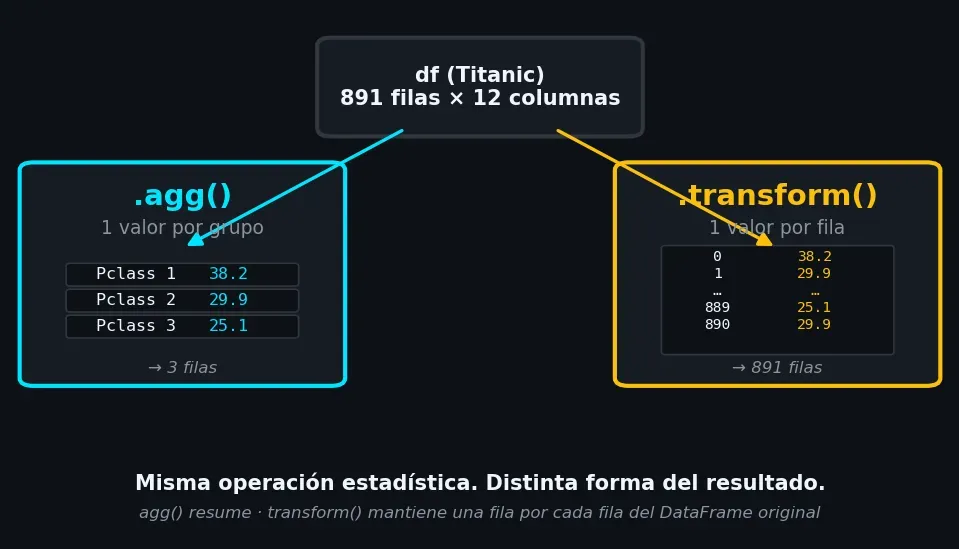
.agg() te devuelve un valor por grupo. Tres clases en Titanic, tres filas. Es la forma natural del resumen: una tabla compacta que cabe en un informe, que se lee de un vistazo, que entra en un print.
df.groupby('Pclass').agg({
    'Age': ['mean', 'std'],
    'Fare': ['mean', 'max'],
    'Survived': 'mean'
})
Resultado: un DataFrame con tres filas (una por clase) y cinco columnas con las estadísticas pedidas. La media de Fare en primera es 84.2 y el ticket más caro llegó a 512.3. En tercera, la media baja a 13.7. Información densa, fila por grupo, leída en vertical.
Y lo mejor: .agg() acepta funciones tuyas, no solo las builtin. Si quieres el rango de edad (max menos min) por clase, lo escribes como una función y se la pasas:
def rango(serie):
    return serie.max() - serie.min()

df.groupby('Pclass')['Age'].agg(rango)
Es el caso “te dan un DataFrame pequeño que cabe en una slide”. Resúmenes, no operaciones sobre filas individuales.
.transform(): un valor por fila
.transform() resuelve un problema diferente, y es donde la mayoría tropieza. Devuelve una Serie del mismo tamaño que el DataFrame original: 891 filas, las mismas que df. Cada valor de la Serie es el estadístico de su grupo, repetido para todas las filas que pertenecen a ese grupo.
class_mean = df.groupby('Pclass')['Age'].transform('mean')
# 891 valores — uno por pasajero, la media de la clase de ese pasajero

df['Age_vs_class'] = df['Age'] - class_mean
# cada pasajero: cuánto se aleja de la media de su clase
Eso es lo que cambia las reglas. Un pasajero de primera con 25 años tiene un Age_vs_class negativo: es más joven que la media de su clase (38.2). Un niño de 8 años en tercera tiene un valor muy por debajo de 25.1. El DataFrame no se ha colapsado: sigue teniendo sus 891 filas, y lo que tiene nuevo es una columna con información de grupo en cada una de ellas.
Es el caso “necesito el estadístico del grupo en cada fila, no en un resumen”. Y en proyectos reales aparece más de lo que parece: edad relativa, salario relativo al departamento, consumo relativo al mes, nota relativa a la media de su curso.
La tabla que lo aclara todo
| Método | Qué devuelve | Cuándo usarlo |
|---|---|---|
.agg() | Un valor por grupo (pocas filas) | Resúmenes: “media por clase” → 3 filas |
.transform() | Un valor por fila (mismas filas que el original) | Añadir al DataFrame: “media de la clase de cada pasajero” → 891 filas |
Si tu siguiente movimiento es un .plot(), un .to_csv() o pegarlo en un informe, necesitas .agg(). Si tu siguiente movimiento es un df['nueva_columna'] = ..., necesitas .transform().
La pregunta trampa que aparece en la UT03
“Quiero una columna salario_relativo que diga si cada empleado cobra más o menos que la media de su departamento.” La respuesta no es .agg(): aunque .agg() te da la media por departamento, te la da en un DataFrame con una fila por departamento, no alineada con cada empleado. .transform() te devuelve un valor por empleado, en el mismo orden que el DataFrame original. Restas y tienes la columna lista. Mezclar las dos cosas es de los errores más caros que he visto en prácticas, y aparece en la UT03 como pregunta casi obligada.
La trampa que se paga en producción
La confusión se vuelve seria cuando los datos se filtran a mitad de pipeline. Imagina que tras limpiar el Titanic te quedas solo con los pasajeros de primera clase, calculas la media de edad, intentas añadirla al DataFrame original con .agg() y… no encaja. Las longitudes no coinciden, Pandas te lanza un ValueError o, peor, te rellena valores con NaN y te enteras dos días después en un gráfico. .transform() lo evita por construcción: si le pides la media por clase, te devuelve 891 valores, uno por fila, sea cual sea el filtro que apliques después. Esa es la diferencia entre un error ruidoso que arreglas en cinco minutos y un resultado silenciosamente mal calculado que se va a una slide.
Usa
.agg()cuando el siguiente paso es resumir: una tabla, un gráfico, un informe. Usa.transform()cuando el siguiente paso es añadir una columna al DataFrame original. La forma del resultado te dice cuál tocar.
La UT03 — Pandas: El dialecto de los datos de Análisis de Datos con Python trabaja este patrón sobre el Titanic completo: groupby, agg, transform, funciones propias y casos reales del estilo “salario relativo al departamento”, paso a paso.
¿Tú también has intentado alguna vez añadir a un DataFrame un resumen de .agg() y te ha explotado con un error de tamaños?